En Barmetmedia ofrecemos soluciones digitales a medida para que tu marca crezca, conecte y venda más. Diseño, estrategia y tecnología, todo en uno, con un enfoque centrado en resultados reales y medibles.
Elegir un modelo de inteligencia artificial ya no es elegir «el mejor». En septiembre de 2026 hay más de treinta modelos relevantes entre servicios de API y modelos instalables, y la diferencia de precioPrecioPrecio La estrategia de marketing enfocada en el precio se refiere al conjunto de procesos y metodologías que una empresa utiliza para establecer el valor de s… entre el más caro y el más barato supera las cien veces. La pregunta útil para una empresa es otra: qué modelo de IA elegir para cada tarea sin pagar de más ni quedarse corto.
En este artículo repasamos los modelos disponibles hoy, cómo se comparan en precioPrecioPrecio La estrategia de marketing enfocada en el precio se refiere al conjunto de procesos y metodologías que una empresa utiliza para establecer el valor de s… y capacidad, y los detalles de la letra pequeña que cambian la factura real. Los precios están en dólares por millón de tokens, tal y como los publican los propios fabricantes.
Antes de mirar la tabla conviene tener claros cinco criterios. Sin ellos, cualquier comparativa de modelos de IA engaña.
1. Precio de entrada, caché y salida
Cada modelo cobra por separado lo que le envías (entrada), lo que reutiliza de peticiones anteriores (lectura de caché) y lo que genera (salida). La salida suele costar entre 3 y 5 veces más que la entrada, así que una tarea que redacta mucho no cuesta lo mismo que una que solo clasifica.
2. Nivel de capacidad
Podemos agrupar los modelos en cuatro niveles: frontera (lo más capaz de cada fabricante), alto, medio y bajo (pensados para volumen y velocidad).
3. Razonamiento
Casi todos los modelos actuales «piensan» antes de responder, y la mayoría permite graduar ese esfuerzo. Más esfuerzo significa mejores respuestas en tareas complejas, pero también más tokens facturados y más latencia.
4. Velocidad
Cuidado aquí: cada fabricante usa sus propias etiquetas («Fast», «Flash», «La más rápida»). No son medidas estandarizadas de tokens por segundo y no se pueden comparar directamente entre marcas.
5. Modalidades
Todos procesan texto; muchos aceptan imagen; solo algunos, como la familia Gemini, aceptan también vídeo y audio de entrada en el mismo modelo.
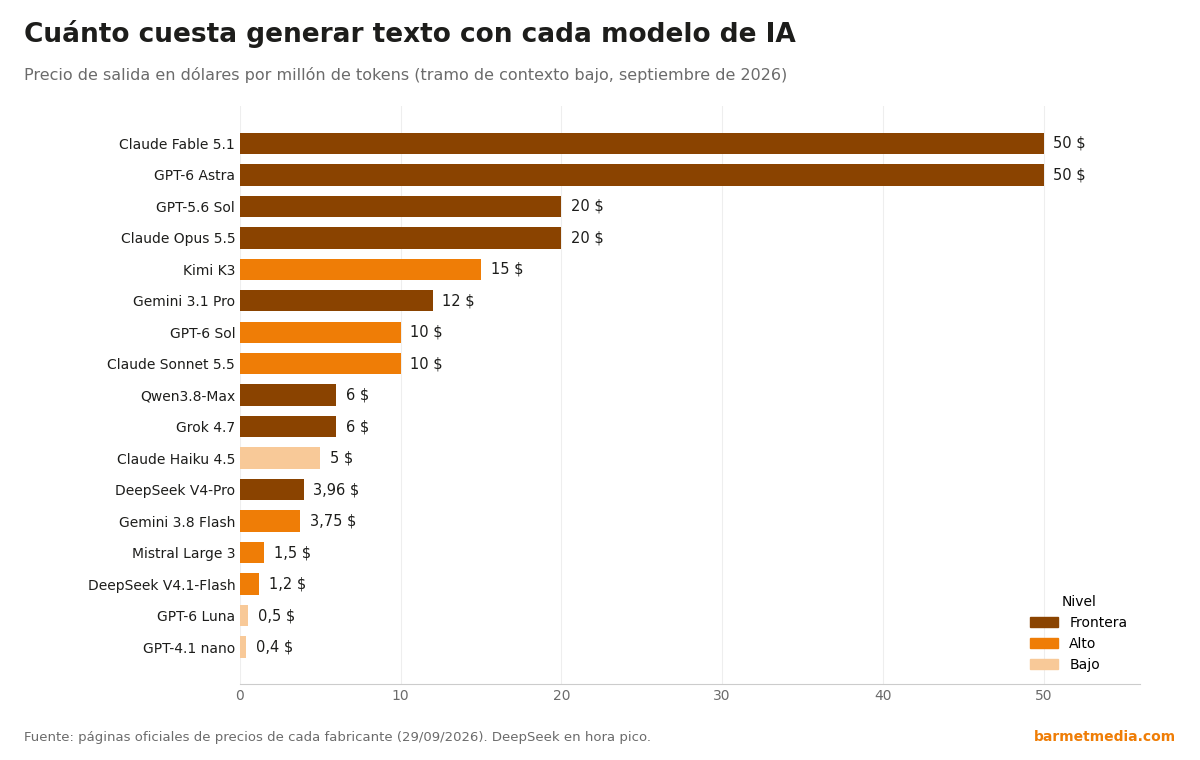
PrecioPrecioPrecio La estrategia de marketing enfocada en el precio se refiere al conjunto de procesos y metodologías que una empresa utiliza para establecer el valor de s… de salida por millón de tokens de los principales modelos de IA, por nivel de capacidad.
Modelos de frontera: para el trabajo difícil
Son los modelos que conviene reservar para tareas de alto valor: análisis complejos, código agéntico, estrategia o documentos críticos.
Modelo
Fabricante
Entrada
Caché
Salida
GPT-6 Astra
OpenAI
10 $
1 $
50 $
Claude Fable 5.1
Anthropic
10 $
0,25 $
50 $
Claude Opus 5.5
Anthropic
4 $
0,20 $
20 $
GPT-5.6 Sol
OpenAI
4 $
0,40 $
20 $
Gemini 3.1 Pro
Google
2 $
0,20 $
12 $
Grok 4.7
xAI
2 $
0,50 $
6 $
Qwen3.8-Max
Alibaba
2 $
0,25 $
6 $
DeepSeek V4-Pro
DeepSeek
1,32 $
0,044 $
3,96 $
Algunas claves de este grupo:
GPT-6 Astra es el modelo más capaz de OpenAI. Acepta imagen, pero no audio ni vídeo en el modelo de chat. Su modo rápido duplica velocidad y precio.
Claude Fable 5.1 es el tope de gama de Anthropic, con la latencia más lenta de su familia. Su lectura de caché cuesta solo el 2,5 % de la entrada.
Claude Opus 5.5 está orientado a código agéntico y trabajo empresarial, a menos de la mitad de precio que Fable.
GPT-5.6 Sol está en promoción al menos hasta el 21 de noviembre de 2026. Si quieres saber más sobre este modelo, lo analizamos en GPT-5.6 Sol y ChatGPT Work.
Gemini 3.1 Pro ofrece contexto de un millón de tokens y es el único de la tabla que acepta texto, imagen, vídeo y audio.
DeepSeek V4-Pro es el frontera más barato. El precio de la tabla es en hora pico; en hora valle cuesta la mitad. No tiene visión.
Modelos de gama alta: el equilibrio para el día a día
Aquí está la mayoría del trabajo real de una empresa: redacción, atención al cliente, automatizaciones con agentes y análisis de documentos.
Modelo
Fabricante
Entrada
Caché
Salida
Kimi K3
Moonshot
3 $
0,30 $
15 $
Claude Sonnet 5.5
Anthropic
2 $
0,20 $
10 $
GPT-6 Sol
OpenAI
2 $
0,20 $
10 $
GPT-4.1
OpenAI
2 $
0,50 $
8 $
Grok 4.6
xAI
2 $
0,50 $
6 $
Grok 4.3
xAI
1,25 $
0,20 $
2,50 $
Gemini 3.8 Flash
Google
0,75 $
0,075 $
3,75 $
Mistral Large 3
Mistral
0,50 $
0,05 $
1,50 $
DeepSeek V4.1-Flash
DeepSeek
0,30 $
0,006 $
1,20 $
Claude Sonnet 5.5 es el Sonnet vigente desde el 28 de septiembre de 2026, con contexto de un millón de tokens y hasta 128.000 de salida. Anthropic lo sitúa un 30 % más rápido que Sonnet 5 al mismo precio.
GPT-6 Sol está pensado para código y flujos de agentes, con esfuerzo de razonamiento graduable.
Gemini 3.8 Flash tiene precio de introducción hasta el 31 de diciembre de 2026. Desde el 1 de enero de 2027 pasa a 1,50 $ de entrada y 7,50 $ de salida: conviene tenerlo en cuenta al presupuestar proyectos de 2027.
Mistral Large 3 tiene precio de API y, además, pesos abiertos: se puede usar como servicio o instalar en infraestructura propia.
DeepSeek V4.1-Flash es, con diferencia, el más económico del grupo, con visión incluida.
Modelos de volumen: cuando el coste por petición manda
Para clasificar correos, etiquetar leads, extraer datos o responder preguntas frecuentes, pagar un modelo de frontera es tirar dinero. Estos modelos cuestan menos de 0,50 $ por millón de tokens de entrada:
Modelo
Fabricante
Entrada
Salida
Jev 1.13
TypeSafe
0,042 $
Gratis
GPT-6 Luna
OpenAI
0,10 $
0,50 $
GPT-4.1 nano
OpenAI
0,10 $
0,40 $
Mistral Small 4
Mistral
0,15 $
0,60 $
GPT-5.6 Luna
OpenAI
0,20 $
1,20 $
Gemini 3.1 Flash-Lite
Google
0,25 $
1,50 $
Gemini 3.5 Flash-Lite
Google
0,30 $
2,50 $
Un caso particular es Jev 1.13: no redacta, solo clasifica, puntúa y enruta. Por eso su salida es gratuita. Encaja como primer filtro en una automatizaciónAutomatizaciónAutomatización Automatización: uso de herramientas tecnológicas para automatizar procesos de marketing lo que permite reducir trabajos manuales y aumentar la e…, decidiendo qué petición pasa a un modelo más caro.
Fuera de este corte de precio, Claude Haiku 4.5 (1 $ / 5 $) es la opción con menor latencia de Anthropic, con pensamiento extendido y contexto de 200.000 tokens.
Modelos instalables: sin precio por token
Llama 4 Maverick, Llama 4 Scout y Llama 3.3 70B (Meta), Qwen3-235B-A22B (Alibaba), Gemma 2 27B (Google) y Phi-4-reasoning (Microsoft) se publican como pesos para instalar. Sus editores no venden un precio por token: el coste es la máquina, y depende de la cuantización, la memoria y el hardware elegido.
Tienen sentido cuando los datos no pueden salir de la empresa, cuando el volumen es tan alto que amortiza el servidor o cuando se necesita control total del modelo. Para la mayoría de pymes, un servicio de API sigue siendo más barato y rápido de poner en marcha.
La letra pequeña que cambia la factura
El tramo de contexto
El precio de las tablas es el del tramo bajo. OpenAI, por encima de 272.000 tokens de entrada, multiplica por dos la entrada y la caché y por 1,5 la salida. Gemini 3.1 Pro y la familia Grok cambian de tarifa a partir de 200.000 tokens. En Grok, además, cruzar ese umbral encarece todos los tokens de la petición, no solo el exceso.
La caché no se cobra igual en todos
OpenAI cobra la lectura al 10 % de la entrada. Anthropic publica tres cifras (escribir durante 5 minutos, escribir durante una hora y leer) y la lectura va del 10 % en Sonnet y Haiku al 5 % en Opus 5.5 y al 2,5 % en Fable 5.1. Google añade un coste por millón de tokens y hora de almacenamiento. En procesos que reutilizan el mismo prompt largo, como un asistente con una base de conocimiento fija, la caché puede reducir el coste de forma drástica.
Hora pico y hora valle
DeepSeek no divide su precio por longitud, sino por hora del día. En hora valle, entrada, caché y salida cuestan la mitad. Si tus procesos pueden ejecutarse de noche, es un ahorro directo.
Precios de promoción
GPT-5.6 Sol y Gemini 3.8 Flash tienen precios temporales. Un presupuesto a doce meses debe calcularse con la tarifa que se aplicará después de la promoción.
Qué modelo de IA elegir según la tarea
Estrategia, análisis complejo o código crítico: un modelo de frontera como Claude Opus 5.5, GPT-6 Astra o Gemini 3.1 Pro.
Agentes y automatizaciones del día a día: gama alta, como Claude Sonnet 5.5 o GPT-6 Sol.
Documentos largos, vídeo o audio: la familia Gemini, por su contexto de un millón de tokens y sus modalidades.
Clasificación y tareas masivas: modelos de volumen como GPT-6 Luna, Gemini Flash-Lite o Jev como primer filtro.
Presupuesto muy ajustado: DeepSeek V4.1-Flash, especialmente en hora valle.
Datos que no pueden salir de la empresa: un modelo instalable o Mistral con pesos abiertos.
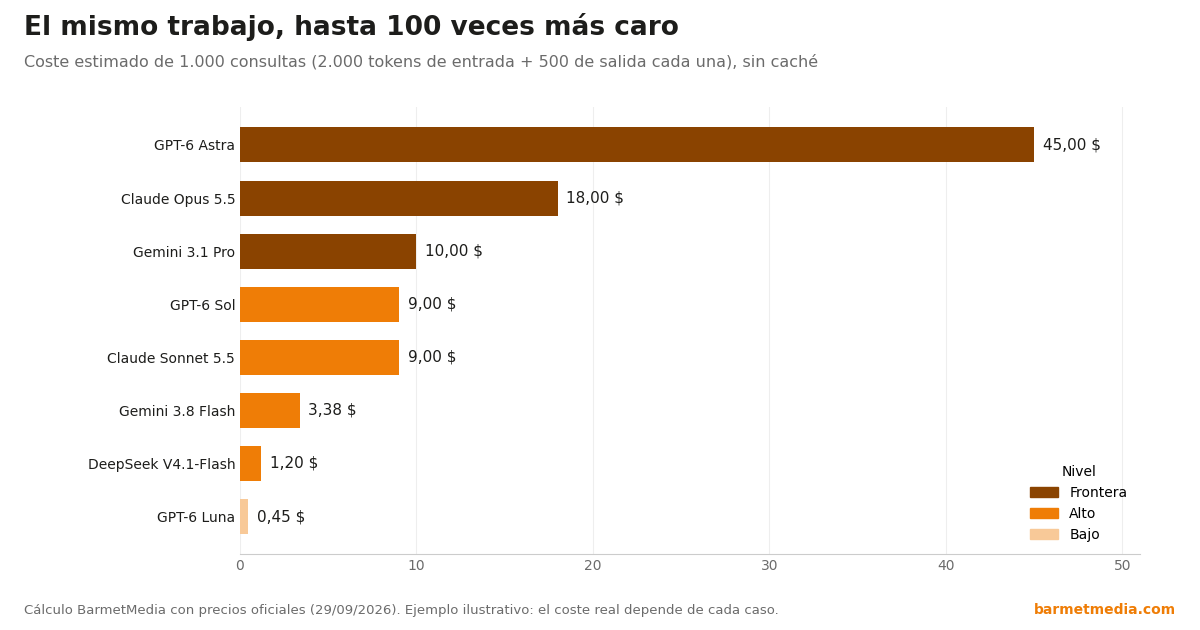
Para dimensionarlo con un ejemplo: 1.000 consultas típicas cuestan unos 0,45 $ con GPT-6 Luna y 45 $ con GPT-6 Astra. La tarea es la misma; la factura, cien veces mayor.
Coste estimado de 1.000 consultas típicas (2.000 tokens de entrada y 500 de salida) según el modelo elegido.
Clave BarmetMedia: la estrategia más rentable no es elegir un solo modelo, sino combinarlos: un modelo barato filtra y clasifica, uno de gama alta ejecuta y uno de frontera interviene solo cuando la tarea lo exige. En procesos de alto volumen, este enrutado puede recortar el coste varias veces sin perder calidad.
Preguntas frecuentes
¿Cuál es el modelo de IA más potente en 2026?
No hay uno solo. En el nivel de frontera están GPT-6 Astra, Claude Fable 5.1, Claude Opus 5.5, GPT-5.6 Sol, Gemini 3.1 Pro, Grok 4.7, Qwen3.8-Max y DeepSeek V4-Pro. Cuál rinde mejor depende de la tarea.
¿Cuál es el modelo de IA más barato?
Entre los que redactan, GPT-6 Luna y GPT-4.1 nano parten de 0,10 $ por millón de tokens de entrada. Para clasificar, Jev 1.13 cuesta 0,042 $ de entrada con salida gratuita.
¿Es mejor usar un modelo instalable que una API?
Solo si necesitas que los datos no salgan de tu infraestructura o si tu volumen justifica el coste del servidor. En la mayoría de los casos, la API es más económica y rápida de implantar.
¿Por qué mi factura no coincide con el precio publicado?
Normalmente por tres motivos: superar el umbral de contexto (200.000 o 272.000 tokens según el fabricante), el coste de escribir y almacenar la caché, o el uso de modos rápidos que duplican el precio.
Cómo te ayudamos en BarmetMedia
En BarmetMedia diseñamos automatizaciones y agentes de IA que combinan el modelo adecuado para cada paso, con el objetivo de que la inteligencia artificial trabaje para tu negocio sin disparar el coste. Si quieres saber qué modelos encajan en tus procesos y cuánto costaría implantarlos, cuéntanos tu caso.
Fuentes
Precios y características según la documentación oficial de cada fabricante, consultada el 29 de septiembre de 2026. Los precios pueden cambiar; revisa siempre la fuente antes de tomar decisiones.
Para ofrecer las mejores experiencias, utilizamos tecnologías como las cookies para almacenar y/o acceder a la información del dispositivo. El consentimiento de estas tecnologías nos permitirá procesar datos como el comportamiento de navegación o las identificaciones únicas en este sitio. No consentir o retirar el consentimiento, puede afectar negativamente a ciertas características y funciones.
Funcional
Siempre activo
El almacenamiento o acceso técnico es estrictamente necesario para el propósito legítimo de permitir el uso de un servicio específico explícitamente solicitado por el abonado o usuario, o con el único propósito de llevar a cabo la transmisión de una comunicación a través de una red de comunicaciones electrónicas.
Preferencias
El almacenamiento o acceso técnico es necesario para la finalidad legítima de almacenar preferencias no solicitadas por el abonado o usuario.
Estadísticas
El almacenamiento o acceso técnico que es utilizado exclusivamente con fines estadísticos.El almacenamiento o acceso técnico que se utiliza exclusivamente con fines estadísticos anónimos. Sin un requerimiento, el cumplimiento voluntario por parte de tu proveedor de servicios de Internet, o los registros adicionales de un tercero, la información almacenada o recuperada sólo para este propósito no se puede utilizar para identificarte.
Marketing
El almacenamiento o acceso técnico es necesario para crear perfiles de usuario para enviar publicidad, o para rastrear al usuario en una web o en varias web con fines de marketing similares.